BLOG BASAL

Modele, wyniki.
I to, co z nich wynika.

Piszemy o kolejnych wydaniach basal, sposobie działania modeli i zastosowaniach, które warto sprawdzić w praktyce.

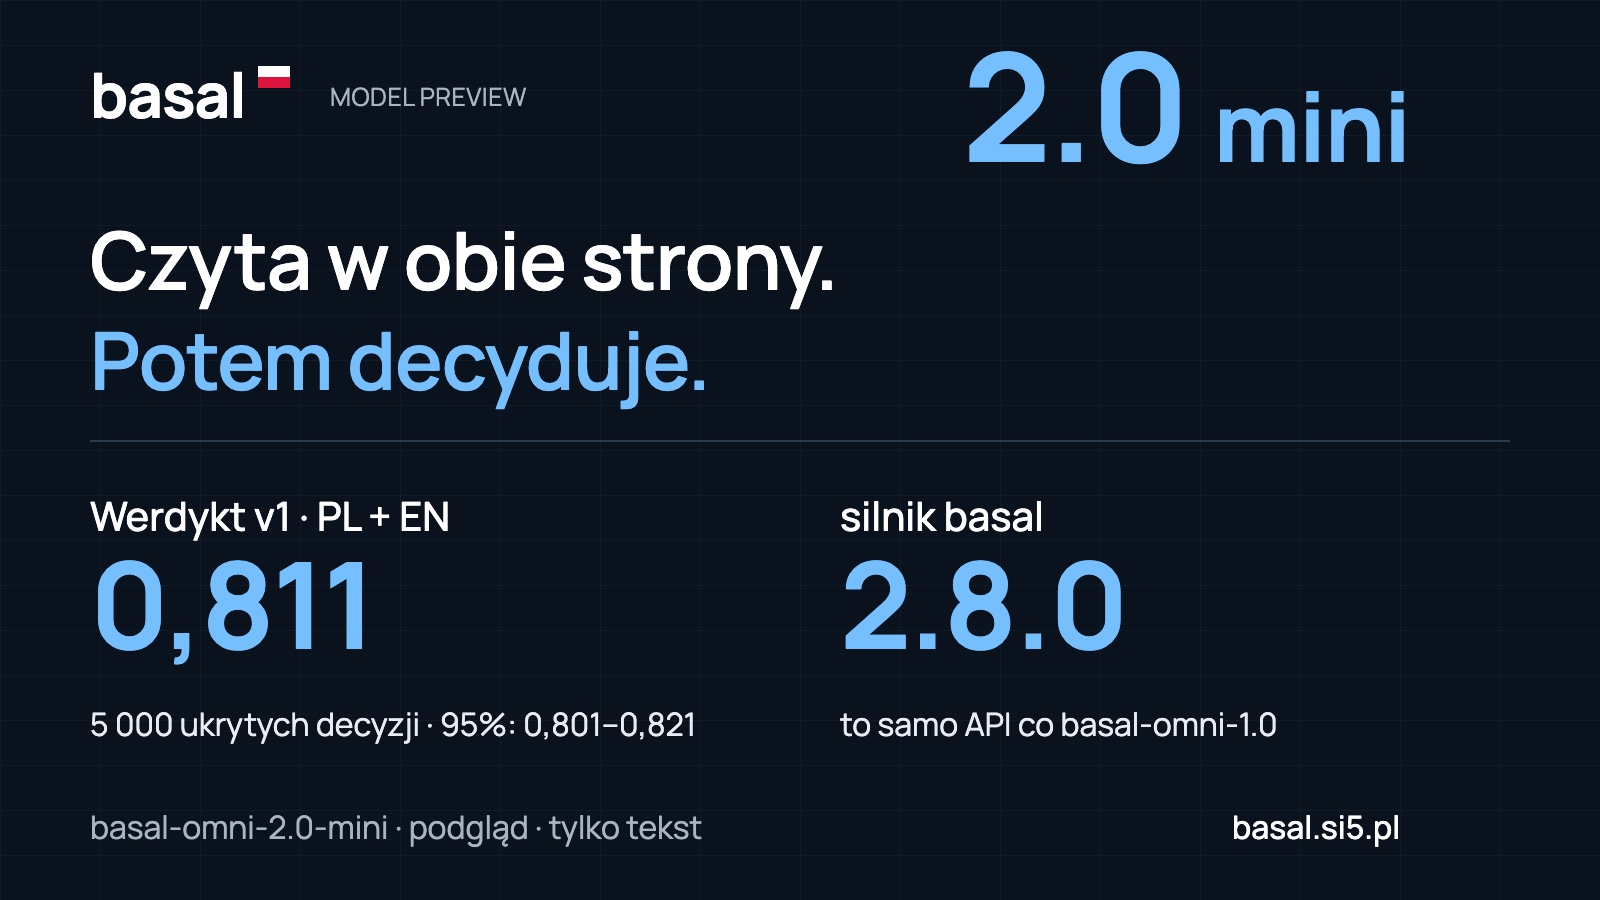
basal-omni-2.0-mini (podgląd): czyta stan w obie strony, potem decyduje. Werdykt v1 PL + EN 0,811 (5 000 ukrytych decyzji, 95% przedział 0,801–0,821); silnik basal 2.8.0, to samo API co basal-omni-1.0; tylko tekst.
Podgląd modelu

basal-omni-2.0-mini (podgląd): czytanie w obie strony i 0,811 w Werdykcie

Wczesne wydanie małego modelu basal-omni 2.0, na Gemma 4 E4B. Model czyta stan w obu kierunkach, zanim odpowie, i ma 0,811 w Werdykcie (5 000 ukrytych decyzji po polsku i angielsku). Działa na publicznym silniku basal 2.8.0, z tym samym API co basal-omni-1.0. Finalne basal-omni 2.0 wydamy później, razem z całą rodziną: nano, mini, max i ultra.
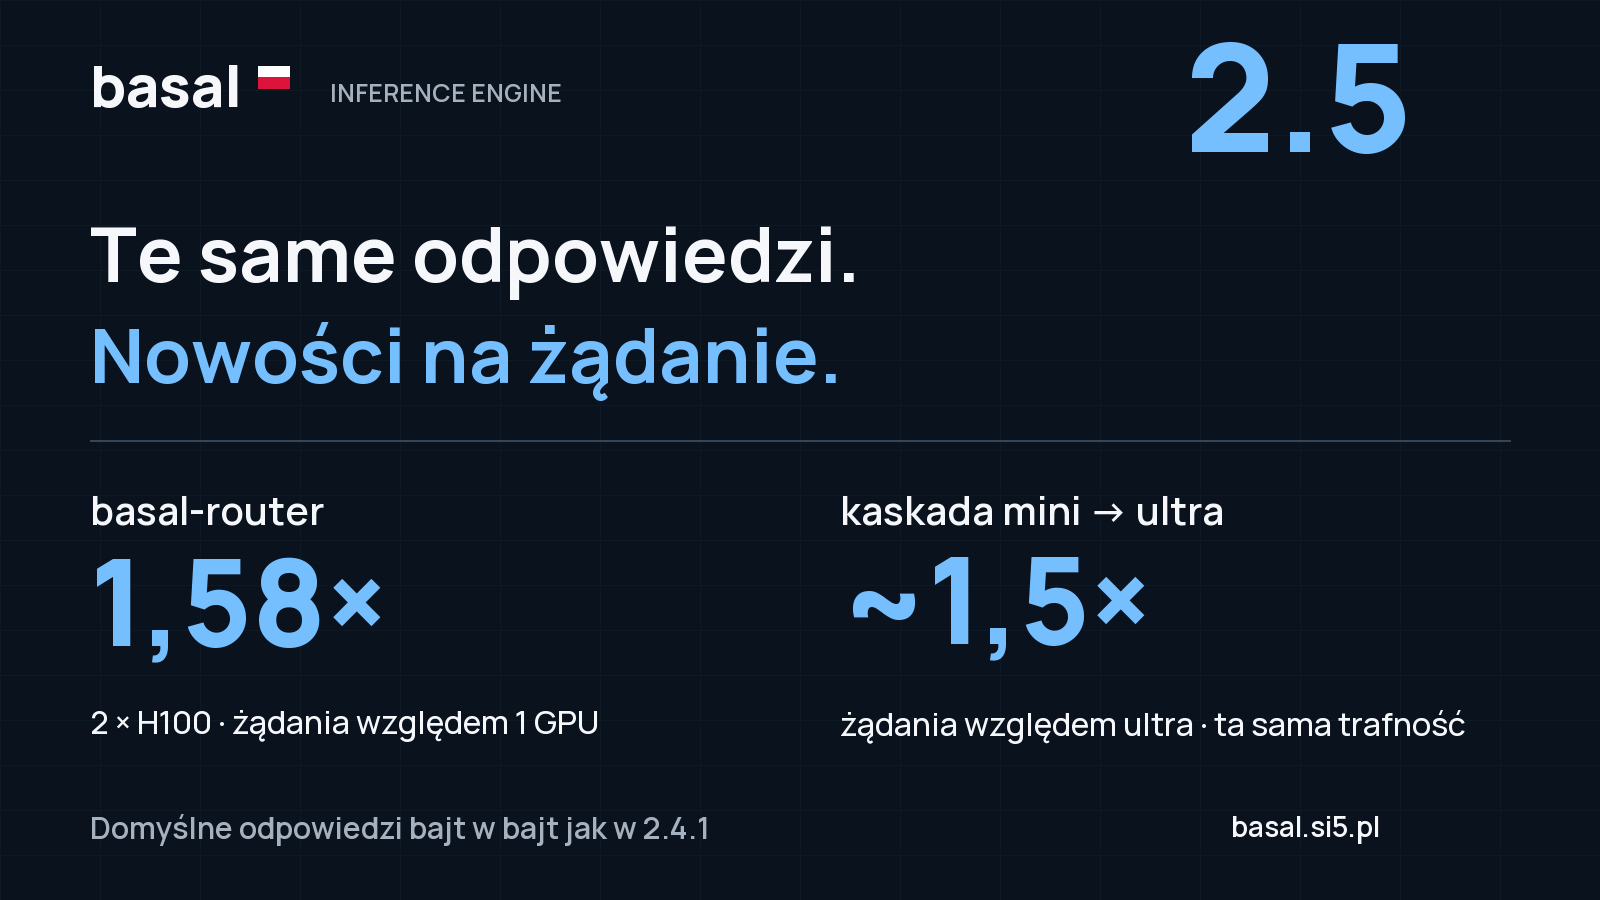
Silnik basal 2.5: basal-router 1,58× żądań na dwóch H100, kaskada mini → ultra około 1,5× żądań przy tej samej trafności; domyślne odpowiedzi bajt w bajt jak w 2.4.1.
Nowe wydanie

Silnik basal 2.5: wiele GPU, kaskada modeli i te same odpowiedzi

Domyślne odpowiedzi są identyczne bajt w bajt z 2.4.1, więc aktualizacja jest bezpieczna, a nowości włączasz sam. basal-router łączy kilka GPU pod jednym portem, kaskada pico → mini → ultra kieruje trudniejsze pytania do większego modelu, a ultra działa w FP8 na jednej karcie 80 GB. Opisujemy też granice tych zmian, filmy w Basal Lab i poprawkę 2.5.1.

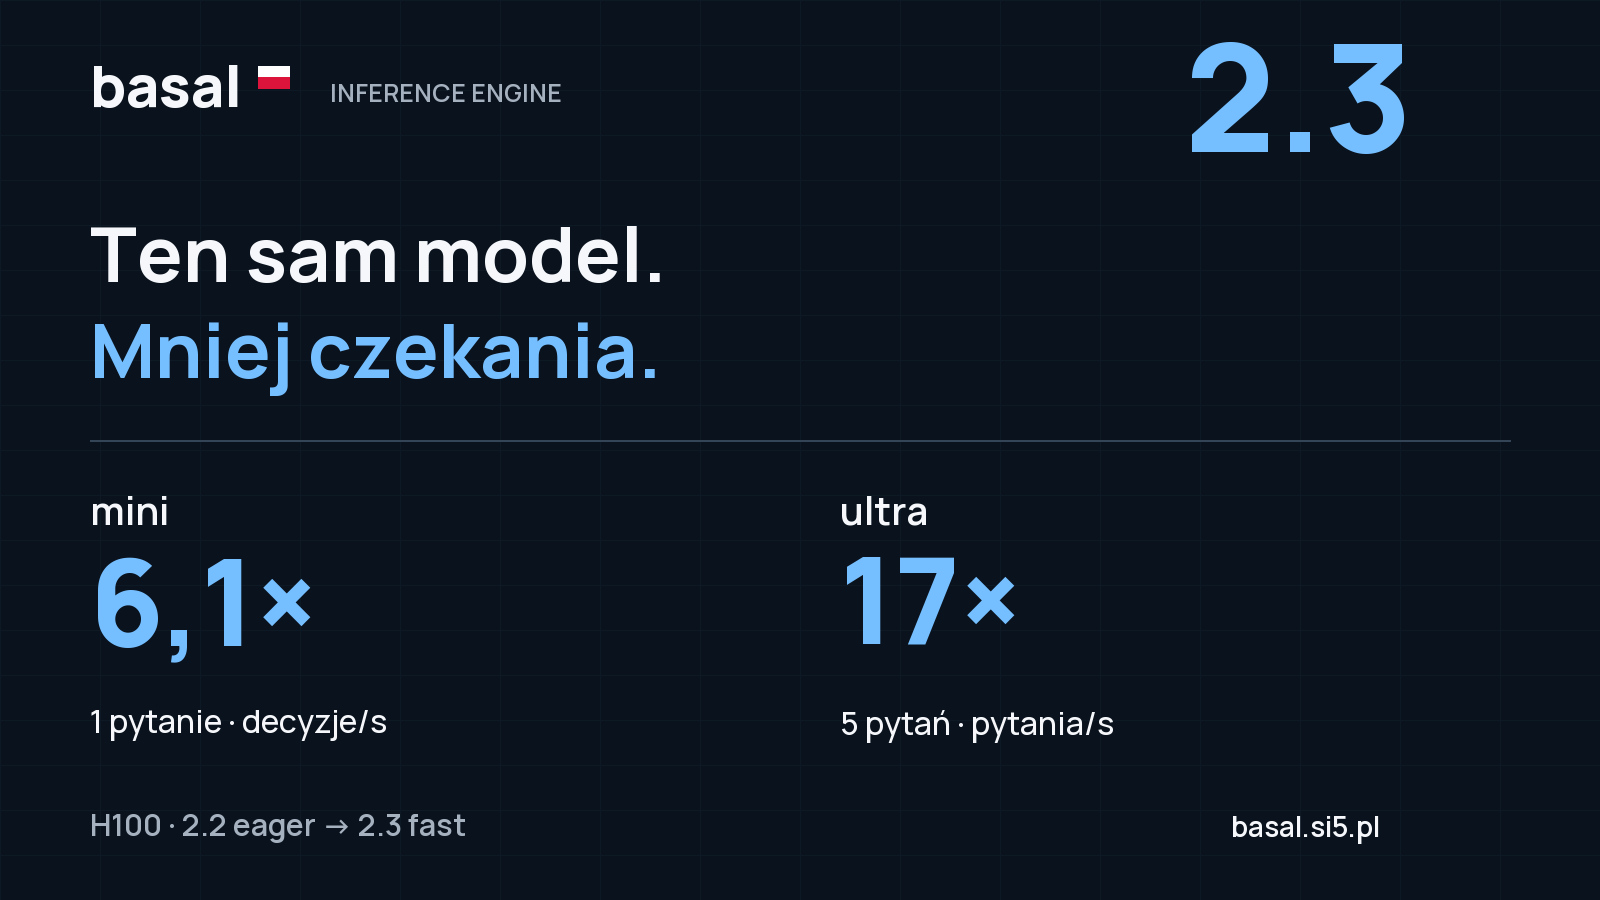
Silnik basal 2.3: mini 6,1× dla jednego pytania, ultra 17× dla pięciu pytań; H100, względem 2.2 eager.
Nowe wydanie

Silnik basal 2.3: ten sam model, do 17× większa przepustowość

basal-omni trafia do szybkiego silnika CUDA graphs. Na H100 pojedyncze pytania zyskują 3,0–6,1×, a pięć pytań o długi dokument — 13,7–17× względem ścieżki eager z 2.2. Wyjaśniamy wspólny kontekst, zoptymalizowane obliczenia, przyspieszenie obrazu i dźwięku oraz granice tego porównania.

Nowe wydanie

Silnik basal 2.2: kalibracja na własnych danych

basal-calibrate w silniku 2.2 sprawdza na Twoich oznaczonych przykładach, czy pewność modelu znaczy to, co mówi, i wyznacza certyfikowane progi. Model decyduje sam tylko tam, gdzie cel błędu jest spełniony, a resztę przekazuje człowiekowi. Do tego porty FP8 i GGUF basal-omni-1.0-mini i max.

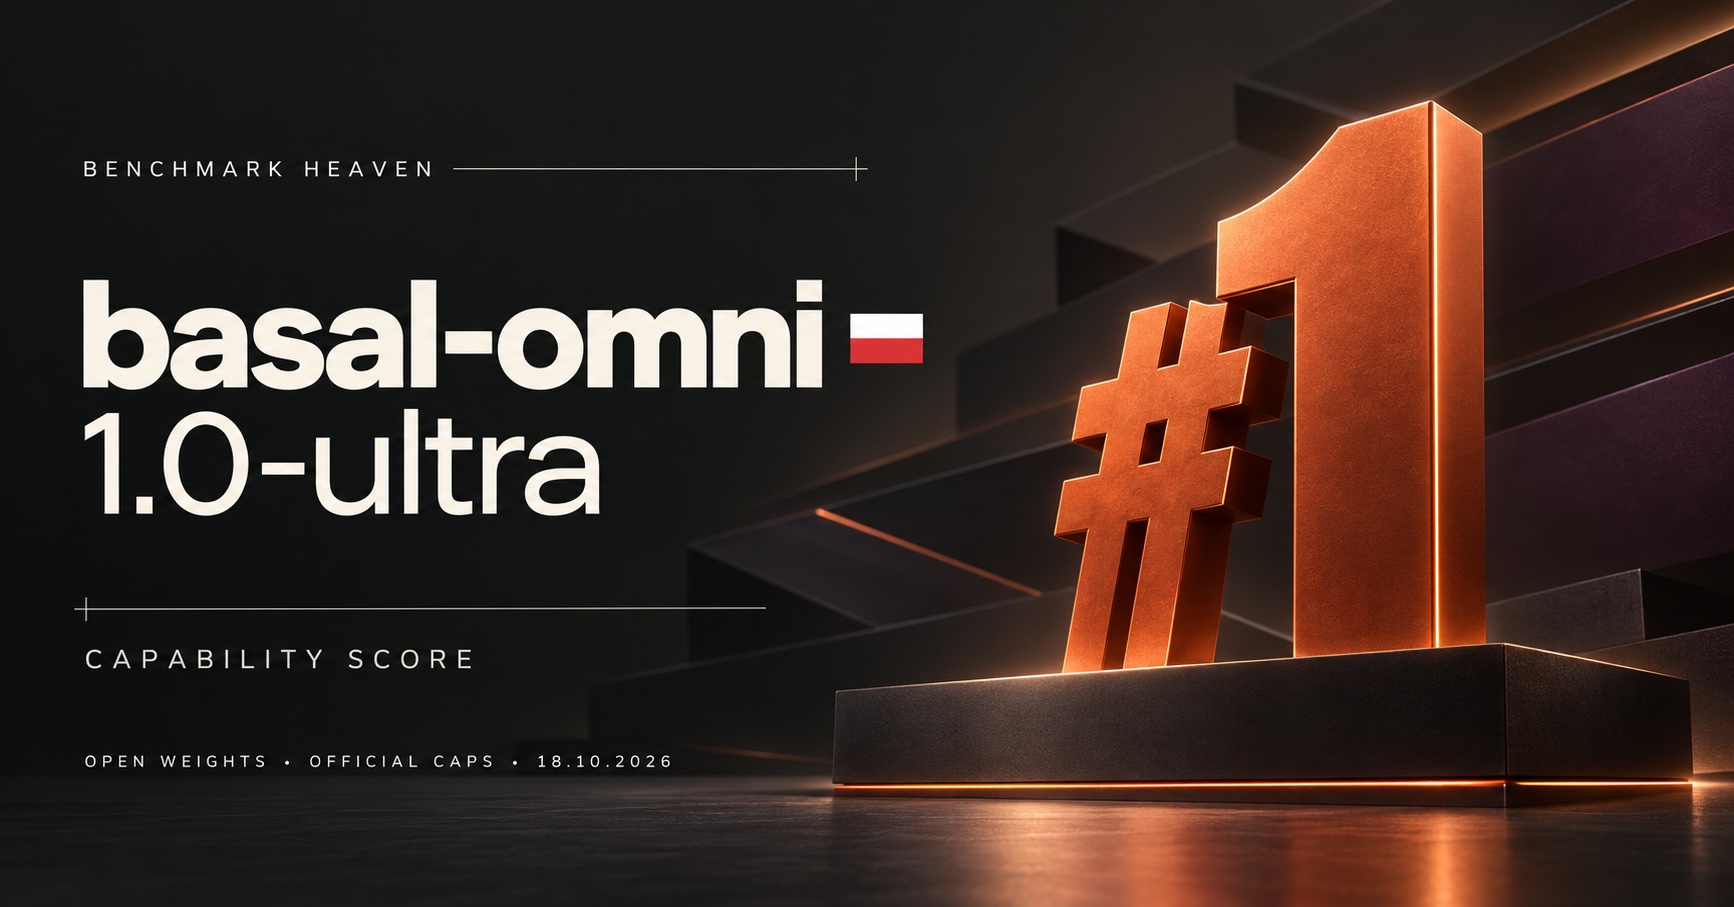
basal-omni-1.0-ultra — numer 1 w JevBench Capability Score dla otwartych wag przy oficjalnych limitach, 18.10.2026.
Wyniki benchmarków

basal-omni numerem 1 w rankingu otwartych modeli Benchmark Heaven

basal-omni-1.0-ultra zajmuje pierwsze miejsce w JevBench Capability Score dla otwartych modeli spełniających limity kosztu i opóźnienia. Z wynikiem 82,54 wyprzedza także OpenAI Decisions i Microsoft-Decision-1. Porównujemy wyniki z Perplexity, Jev i czołówką otwartych modeli oraz wyjaśniamy warunki pomiaru.

Nowe wydanie

basal-omni-1.0-ultra i silnik basal 2.1

Najbardziej zaawansowany model rodziny basal: basal-omni-1.0-ultra (31B) ma 0,879 w Werdykcie, o 5,8 punktu więcej niż Jev 1.14, i jest na równi z Liquid d1-ultra. Silnik basal 2.1 dodaje eksperymentalne zadania classify, verify, compress i extract, a pozostałe odpowiedzi zostawia bez zmian. Do zadań dochodzi eksperymentalny basal-omni-1.1-max.

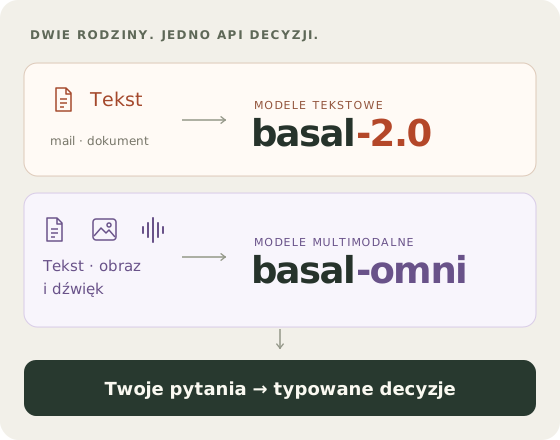
Tekst trafia do basal-2.0. Tekst, obraz i dźwięk trafiają do basal-omni. Obie rodziny zwracają typowane decyzje przez wspólne API.
Nowe wydanie

basal-2.0 i basal-omni — więcej decyzji na sekundę, lepsza kalibracja, obraz i dźwięk

Trzy otwarte modele decyzyjne basal-2.0 dla polskiego i angielskiego: od 1,4 do 5,2 razy więcej decyzji na sekundę niż basal-1.5, lepiej skalibrowane prawdopodobieństwa, do 255 opcji w pytaniu i porty z własną kalibracją. Obok nich eksperymentalny basal-omni: dwa modele na Gemma 4, które czytają również obrazy i dźwięk. Piszemy też, gdzie nowe modele nie są lepsze i jak wypadają na tablicy Werdyktu.

Nowe wydanie

basal-1.5 — trzy modele, więcej możliwości

Dynamiczny klasyfikator definiowany w każdym zapytaniu, bez dodatkowego treningu. Trzy rozmiary, nowe schematy odpowiedzi, szybsze przetwarzanie wielu pytań i pełne wyniki benchmarku Werdykt — także po polsku.

Poznaj model

basal-1.0 - dynamiczny klasyfikator

Otwarty klasyfikator dla języka polskiego i angielskiego. Jak działa, co potrafi i ile czasu potrzebuje na decyzję — od serwera z B300 po biurkowy HP ZGX Nano (Nvidia DGX Spark).

OD LEKTURY DO DZIAŁANIA

Masz proces, który czeka na decyzję?

Zobacz przykładowe zapytania i odpowiedzi dla 18 zastosowań klasyfikatora.

Otwórz katalog zastosowań