Silnik basal 2.3: ten sam model, do 17× większa przepustowość
basal-omni trafia do szybkiego silnika CUDA graphs. Na H100 pojedyncze pytania zyskują 3,0–6,1×, a pięć pytań o długi dokument — 13,7–17× względem ścieżki eager z 2.2. Wyjaśniamy wspólny kontekst, zoptymalizowane obliczenia, przyspieszenie obrazu i dźwięku oraz granice tego porównania.
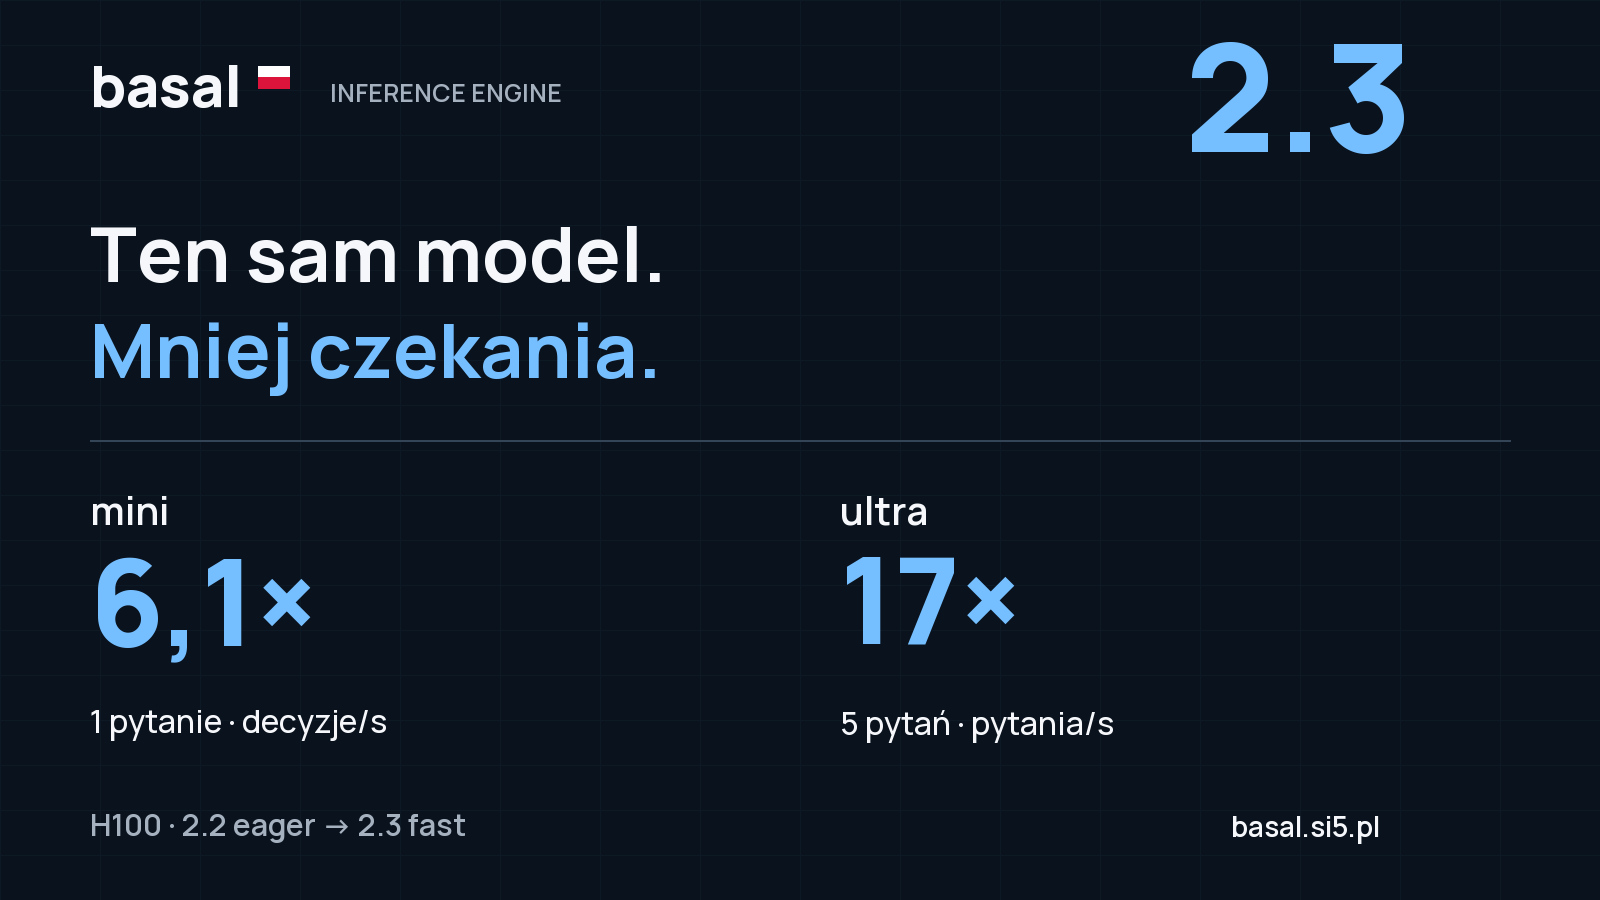
Przychodzi dokument. Aplikacja chce rozpoznać jego rodzaj, wybrać zespół, ocenić pilność i sprawdzić kilka warunków. To kilka decyzji o tym samym tekście. Wydany 20 października silnik basal 2.3 pozwala modelom basal-omni wykonać tę pracę znacznie sprawniej: przygotowuje wspólny kontekst raz, a potem wykorzystuje go w kolejnych pytaniach.
To wydanie silnika inferencji, nie nowy trening wag. Porównujemy te same modele z rodziny basal-omni na tym samym GPU. W przypadku mini w BF16 przepustowość rośnie z 10,0 do 61,2 decyzji/s. Przy pięciu pytaniach o długi dokument ultra rośnie z 0,28 do 4,8 pytań/s. Główne porównanie dotyczy wejścia tekstowego: 2.2 eager → 2.3 fast.
Źródło liczb i konfiguracji: wydanie v2.3.0. Ultra w 2.2 wymagał mniejszej równoległości z powodu pamięci; pełne warunki pod tabelą.
W skrócie: skąd bierze się przyspieszenie
Od „czas to pieniądz” Franklina do szybszego silnika: 43 sekundy o wspólnym kontekście i dwóch pomiarach. Polski lektor; napisy można przełączyć na polskie lub angielskie.
Cytat: Benjamin Franklin, „Advice to a Young Tradesman”, 1748. Portret: Henry Wolf, 1898, Smithsonian American Art Museum, domena publiczna.
Jeden kontekst, wiele pytań
W 2.2 szybki silnik z grafami CUDA obsługiwał modele basal-2.0 oparte na Bieliku. Rodzina basal-omni, oparta na Gemma 4, korzystała z eager albo z osobnej integracji vLLM. W dotychczasowej ścieżce eager każde pytanie ponownie przetwarzało cały stan.
W 2.3 ten szybki silnik obsługuje również Gemma 4. Oblicza reprezentacje stanu — klucze i wartości używane przez uwagę — raz na żądanie. Następnie obsługuje nad nimi wszystkie pytania i kolejności opcji. Także warstwy z przesuwającym się oknem zachowują taki zakres widocznego kontekstu, jaki pytanie miałoby w osobnym zapytaniu.
- Aplikacja wysyła jeden state i wiele questions. Wszystkie pytania dotyczą tego samego dokumentu.
- Silnik oblicza wspólną część. Nie powiela przygotowania tego samego kontekstu dla każdego pytania.
- Model zwraca oddzielne decyzje. Każde pytanie zachowuje własny typ, opcje i wynik.
Zysk dotyczy pytań w jednym żądaniu. Wysyłanie pięciu osobnych żądań nie jest tym samym co umieszczenie pięciu pytań przy wspólnym state.
Wyniki na H100: pojedyncze i wielokrotne pytania
Oba pomiary używają tego samego GPU i tego samego zestawu testowego wydajności. Pojedyncze pytanie dotyczy stanu około 1 500 tokenów. W drugim profilu każde żądanie zawiera pięć pytań do stanu liczącego 3 000–10 000 tokenów.
| Model | 1 pytanie: decyzje/s | Wzrost | 5 pytań: pytania/s | Wzrost |
|---|---|---|---|---|
| basal-omni-1.0-mini | 10,0 → 61,2 | 6,1× | 1,56 → 21,4 | 13,7× |
| basal-omni-1.1-max | 4,8 → 16,2 | 3,4× | 0,72 → 10,6 | 14,7× |
| basal-omni-1.0-ultra | 2,0 → 6,1 | 3,0× | 0,28 → 4,8 | 17× |
16 żądań równolegle. Wyjątek: ultra w 2.2 mieścił 4 żądania dla pojedynczego pytania i 2 dla pięciu pytań; przy większej równoległości brakowało pamięci. Wynik ultra obejmuje więc również możliwość utrzymania większego obciążenia w 2.3. Mnożniki pochodzą z dokładnych pomiarów; wartości w tabeli są zaokrąglone.
Przepustowość nie jest czasem pojedynczej odpowiedzi. 61,2 decyzji/s mówi, ile pracy obsłuży serwer przy podanym obciążeniu. Nie oznacza, że każde żądanie ma opóźnienie 1/61,2 sekundy. Tak samo 4,8 pytań/s przy pięciu pytaniach na dokument oznacza około 0,96 takich żądań/s.
Osobno zmierzyliśmy gotowy checkpoint mini-FP8: 80,6 decyzji/s dla jednego pytania. To 8,0× względem bazowego mini BF16 w eager. Ponieważ zmienia się także format wag, nie włączamy tego wyniku do głównego porównania BF16.
Na RTX PRO 6000 Blackwell Max-Q mini uzyskał 5,6 → 23,2 decyzji/s, a max 1.0: 2,3 → 5,0. Pięć pytań dało odpowiednio 0,85 → 18,4 i 0,37 → 5,3 pytań/s. W 2.3 to ścieżka włączana jawnie przez --mode fast --gemma-attn flex, oczekująca na zakończenie kontroli kalibracji na tej karcie. Nie jest jeszcze domyślną konfiguracją Blackwell.
Co zmieniliśmy w obliczeniach
- Tylko potrzebne pozycje odpowiedzi. W mini ostatnie 18 z 42 warstw korzysta z wcześniej wyliczonych kluczy i wartości. Liczymy je tylko w pozycjach, z których odczytujemy odpowiedzi — około 40% mniej obliczeń na decyzję. W max i ultra podobna optymalizacja dotyczy ostatniej warstwy.
- Uwaga dopasowana do architektury. Na Hopperze FlashAttention 3 obsługuje warstwy z przesuwającym się oknem, a FlexAttention — globalne warstwy o szerokości głowy 512. Zastępuje to powolną ścieżkę referencyjną.
- Mniej narzutu wykonania. Łączymy projekcje q/k/v oraz gate/up, kompilujemy warstwy i odtwarzamy obliczenia w grafach CUDA. Zwarte paczki ograniczają niepotrzebne dopełnianie.
- Mniej pamięci kontekstu. W warstwach okienkowych przechowujemy tylko ostatnie okno kluczy i wartości. Dla ultra przy stanie 10 000 tokenów ten fragment cache spada z 9 do 1,6 GB. To nie jest całkowite zużycie VRAM. Bufor roboczy cuBLAS na graf zmniejszyliśmy z 32 do 8 MB.
Co z obrazem, dźwiękiem i vLLM?
Tryb fast opisany wyżej przetwarza tekst. Dla obrazów, dźwięku, evidence i trybu deterministycznego jest ścieżka eager. Ona również korzysta teraz z własnego przebiegu obliczeń Gemma 4: stan i enkodery mediów uruchamiają się raz na żądanie, zamiast raz na pytanie.
W pomiarze max dla trzech pytań o jeden obraz mediana czasu spadła z 204 do 131 ms, czyli o około 36%. To konkretny pomiar opóźnienia multimodalnego. Nie przenosimy na niego mnożnika 17× z tekstowego testu ultra.
W samym eager mini rośnie z 10,0 do 17,2 decyzji/s dla jednego pytania i z 1,56 do 15,3 pytań/s przy pięciu pytaniach. Max w tym drugim profilu rośnie z 0,72 do 4,5 pytań/s. Opcjonalne --eager-attn auto przyspiesza uwagę na Hopperze. Dla mini --ple-offload on przenosi tablicę embeddingów warstwowych do RAM: oszczędza 5,2 GB VRAM kosztem około 4% przepustowości.
- vLLM: szybsze przygotowanie mini. Pomijanie niepotrzebnych pozycji we współdzielonych warstwach jest włączone domyślnie. Na H100: 41,5 → 60,8 decyzji/s dla jednego pytania oraz 24,2 → 39,0 pytań/s przy pięciu. Tu bazą jest poprzednia ścieżka vLLM, nie eager.
- vLLM: media w mini. Obrazy i dźwięk są obsługiwane przez
--mode vllm --media on. W testach przy 8 równoległych żądaniach przepustowość wyniosła odpowiednio 6,0× i 7,9× względem eager. Zgodność wybranej odpowiedzi wyniosła 96,5% dla obrazów i 98,3% dla audio; 100% w podzbiorze pewnych decyzji. Obsługa mediów w 1.1-max przez vLLM jest jeszcze blokowana, ponieważ nie przeszła wymaganego testu zgodności. - vLLM: powtarzalne prawdopodobieństwa.
--vllm-preset deterministicdał identyczne bitowo wyniki dwóch przebiegów 1.1-max na 10 606 decyzjach. W zamian przepustowość wyniosła 0,64× profilu zwykłego dla jednego pytania i 0,22× dla pięciu. Powtarzalność jest świadomym wyborem, nie darmowym przyspieszeniem.
Szybkość pod kontrolą jakości
Wprowadzając szybsze obliczenia BF16, sprawdziliśmy nie tylko liczbę decyzji na sekundę. Na 10 606 decyzjach developerskich, z jedną kolejnością opcji, trafność zmieniła się o najwyżej 0,06 punktu procentowego. Zgodność najwyżej ocenionej odpowiedzi wyniosła około 98,9–99,4% ogółem, a w podzbiorze z marginesem co najmniej 0,2 — 99,85–99,99%. Te wartości mierzą zgodność ścieżek, a nie procent poprawnych odpowiedzi.
Przy niemal równych opcjach inne zaokrąglenia BF16 mogą zmienić zwycięzcę. Nie obiecujemy identycznych bitowo wyników w szybkim trybie. Fast używa dostarczonego z modelem CALIBRATION.json. W wykonanej kontroli odsetek automatyzacji przy celu błędu 1% zmienił się o mniej niż 0,1 punktu procentowego, a obserwowany błąd pozostał poniżej celów 1% i 5%. To wynik na sprawdzonym zbiorze, nie gwarancja dla dowolnej nowej dziedziny.
Dlatego po aktualizacji warto ponownie zmierzyć własne zapytania i kalibrację. Narzędzia z silnika 2.2 pozostają dostępne.
Poprawki i wkład społeczności
Omni bez jawnego --mode nie zatrzymuje się już podczas uruchamiania na GPU. Na Hopperze z FlashAttention 3 wybierany jest fast, na innych GPU — eager. Rozszerzyliśmy też ochronę przed znanym błędem uwagi PyTorch na wszystkie modele w starszych wersjach biblioteki. Obsługiwane konfiguracje basal w 2.2 były już zabezpieczone.
Wkład Milosza (@Butterski, #17) usuwa kolejne powtórzenie: język promptu jest wykrywany raz na żądanie. W teście compress z 40 tysiącami znaków i 326 pytaniami ten etap skrócił się z 509 do 2 ms. To czas przygotowania, nie czas całej inferencji.
Przyspieszenia opisane w tym wpisie dotyczą rodziny basal-omni. Modele tekstowe basal-2.0 na Bieliku korzystają z dotychczasowej szybkiej ścieżki. Osobny pomiar 2.3 kontra 2.2 dla Bielika jest zaplanowany na 2.3.1. Do 2.3 nie weszły też eksperymenty z cache KV w FP8 ani kwantyzacja wag wykonywana przy ładowaniu, które nie spełniły wymagań.
Jak uruchomić i wykorzystać zmianę
Zainstaluj wydanie 2.3.0 w środowisku zgodnym z wymaganiami GPU w dokumentacji. Przykład dla 1.1-max:
uv pip install "basal[media] @ https://github.com/rkinas/basal/archive/refs/tags/v2.3.0.tar.gz"

basal-serve --model Remek/basal-omni-1.1-max --port 8000

basal-serve --model Remek/basal-omni-1.1-max --mode eager --media on
Pierwsze uruchomienie wybierze fast na Hopperze z FlashAttention 3. Ostatnia komenda pokazuje alternatywne uruchomienie dla mediów. Wysyłając kilka pytań o jeden dokument, umieść je razem w questions:
{
  "state": "Zgłoszenie klienta: zamówiona szafa dotarła z pękniętymi drzwiami. Proszę o wymianę drzwi do piątku. Nie żądam zwrotu pieniędzy.",
  "questions": {
    "rodzaj": {
      "type": "choice",
      "instructions": "Jaki to rodzaj wiadomości?",
      "criteria": {
        "reklamacja": "Zgłoszenie problemu z zakupem",
        "oferta": "Zapytanie o nowy zakup",
        "inne": "Inna sprawa"
      }
    },
    "zespol": {
      "type": "choice",
      "instructions": "Który zespół powinien obsłużyć sprawę?",
      "criteria": {
        "serwis": "Naprawy i wymiana elementów",
        "sprzedaz": "Nowe zamówienia",
        "ksiegowosc": "Rozliczenia"
      }
    },
    "pilnosc": {
      "type": "score",
      "instructions": "Jak pilna jest sprawa według podanego terminu?",
      "criteria": [
        "Brak terminu",
        "Termin w tym tygodniu",
        "Natychmiastowe zagrożenie"
      ]
    },
    "uszkodzenie": {
      "type": "noul",
      "instructions": "Czy klient zgłasza fizyczne uszkodzenie towaru?"
    },
    "zwrot": {
      "type": "noul",
      "instructions": "Czy klient żąda zwrotu pieniędzy?"
    }
  }
}
To przykładowe żądanie, nie przypadek użyty do liczb w tabeli. Wyników ani prawdopodobieństw tego przykładu nie symulujemy. Reguły procesu i działania po odpowiedzi pozostają po stronie aplikacji.
Korzyść jest konkretna: mniej powtarzanych obliczeń i więcej obsłużonych pytań na tej samej karcie. Przy stałej cenie GPU i odpowiednim obciążeniu może to obniżyć koszt decyzji. Wartość dla Twojej firmy policz na własnej długości dokumentów, liczbie pytań i wymaganym czasie odpowiedzi.
Pełny opis wydania i pomiary → · Serwer inferencji, REST i MCP →