Silnik basal 2.5: wiele GPU, kaskada modeli i te same odpowiedzi
Domyślne odpowiedzi są identyczne bajt w bajt z 2.4.1, więc aktualizacja jest bezpieczna, a nowości włączasz sam. basal-router łączy kilka GPU pod jednym portem, kaskada pico → mini → ultra kieruje trudniejsze pytania do większego modelu, a ultra działa w FP8 na jednej karcie 80 GB. Opisujemy też granice tych zmian i plan na 2.5.1.
Gdy system decyzyjny zaczyna obsługiwać prawdziwy ruch, pojawiają się nowe pytania. Co zrobić, gdy jedno GPU nie wystarcza? Jak przekazać trudniejsze przypadki większemu modelowi? Kiedy lepiej nie automatyzować odpowiedzi? Wydany 2 listopada silnik basal 2.5 daje na te pytania nowe narzędzia i nie zmienia odpowiedzi, które już znasz.
Domyślne odpowiedzi są identyczne bajt w bajt z 2.4.1. Sprawdziliśmy to na H100 dla basal-omni-1.0-mini, basal-omni-1.0-max i basal-omni-pico w --mode fast oraz dla mini i pico w --mode eager. Aktualizacja jest więc bezpieczna. Prawie wszystko, co nowe, włączasz sam: flagą serwera albo polem w żądaniu.
Źródło liczb i konfiguracji: wydanie v2.5.0 i dokumentacja w repozytorium. Kaskadę mierzyliśmy na odłożonej połowie zbioru, na jednym H100.
Bezpieczna aktualizacja
Zasada tego wydania jest prosta: jeśli nie zmieniasz konfiguracji, dostajesz te same prawdopodobieństwa co w 2.4.1. Notatki do wydania wymieniają cztery zmiany na domyślnej ścieżce. Dotyczą obsługi żądań, a nie samych decyzji:
- Nazwy pytań z
::. W żądaniu z pytaniami typu zadanie pytanie o nazwie<zadanie>::<część>jest odrzucane (HTTP 422). Wcześniej zadanie mogło odczytać jego odpowiedź jako własną (#59). - Czytelniejsze błędy. Treść błędu ma pole
code(INVALID_REQUEST,OUT_OF_MEMORY,INTERNAL_ERROR), a odpowiedź 422 takżedetail. Poleerrorzachowuje dotychczasowy tekst (#62). - Więcej w
GET /v1/models. Lista modeli podaje certyfikowane progi dla każdego celumax_errori typu pytania oraz parametry kontekstu (#64). - Identyfikator żądania. Każda odpowiedź ma nagłówek
x-request-id(#68).
Jedna domyślna zmiana przyspiesza pracę bez zmiany wyników. Serwer tokenizuje wspólną część promptów, czyli szablon i stan, tylko raz. Silnik dostaje te same identyfikatory tokenów co wcześniej. Żądanie rank z 300 kandydatami i stanem 12,5 tys. tokenów zajmuje 0,14 s CPU zamiast 5,8 s.
Są też poprawki. Puste "questions" daje teraz HTTP 422 zamiast 500. Edytowane stany czatu z cache stanu nie kończą się już błędem 500 z wartościami NaN. Na basal-omni-1.0-ultra błąd dotyczył 27 z 1 248 takich żądań, po poprawce żadnego. Wersja 2.4.1 miała ten sam problem.
Wiele GPU i kaskada modeli
basal-router łączy kilka replik basal-serve pod jednym portem. Opcja --gpus 0,1 uruchamia po jednej replice na GPU i zatrzymuje je razem z routerem, także gdy router zostanie zabity. Żądania o ten sam stan trafiają do tej samej repliki (routing po skrócie stanu z ograniczeniem obciążenia), więc jej cache stanu dalej działa. Replika, która odpowiada 503 albo milczy, nie dostaje żądań, dopóki nie będzie gotowa.
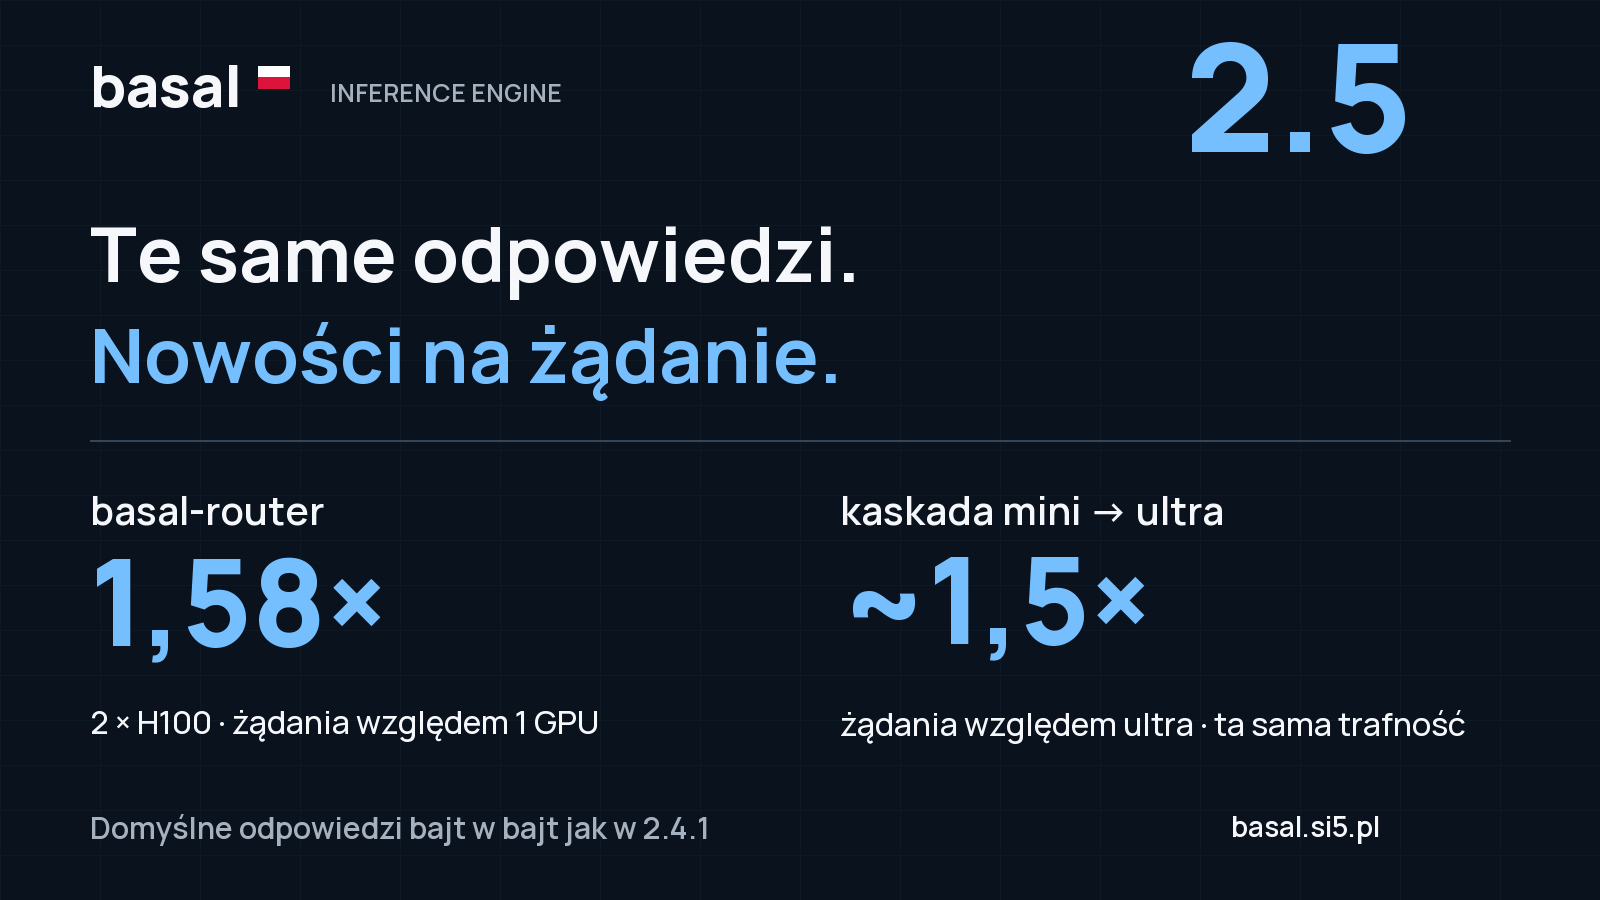
Na dwóch H100 router obsłużył 1,58× tyle żądań co jedno GPU, przy dwukrotnie większej liczbie klientów. Skalowanie nie jest jeszcze liniowe: dwa GPU to na razie nie dwa razy więcej pracy.
Kaskada (--escalate, --escalate-below) zadaje pytanie ponownie większemu modelowi, gdy najwyższe prawdopodobieństwo jest poniżej progu. Poziomy można łączyć, na przykład basal-omni-pico → mini → ultra, każdy z własnym progiem:
basal-serve --model Remek/basal-omni-pico --port 8001 &
basal-serve --model Remek/basal-omni-1.0-mini --port 8002 &
basal-serve --model Remek/basal-omni-1.0-ultra --port 8003 &
basal-router --replicas http://127.0.0.1:8001 \
    --escalate http://127.0.0.1:8002 --escalate-below 0.8 \
    --escalate http://127.0.0.1:8003 --escalate-below 0.9 --port 8000
Każda odpowiedź mówi, który model jej udzielił (answered_by), a przy dwóch i więcej poziomach podaje też poziom. /metrics liczy odpowiedzi na każdym poziomie. Gdy któryś poziom nie działa, zostaje odpowiedź z poprzedniego i żądanie nie kończy się błędem. Opcja --route kieruje stany w jednym alfabecie, na przykład cyrylicy, do osobnych replik.
Na odłożonej połowie zbioru kaskada mini → ultra z progiem 0,95 obsłużyła około 1,5× tyle żądań co sam ultra na jednym H100, przy tej samej trafności (w granicach 0,5 pkt). Ultra dostaje tylko pytania, przy których mini nie jest pewny.
Blend (--blend) działa odwrotnie. Każde pytanie trafia do kilku modeli, a router zwraca ważoną średnią ich prawdopodobieństw. Mieszanka 0,6 ultra + 0,2 mini + 0,2 pico dała +0,45 pkt względem samego ultra (95% przedział: od +0,09 do +0,81). To opcja dla jakości, nie dla szybkości.
Rezerwa LLM (--fallback) działa po ostatnim poziomie. Pytanie wyboru, którego najwyższe prawdopodobieństwo wciąż jest poniżej progu T, trafia do modelu czatu, który serwujesz za endpointem zgodnym z OpenAI. Jego odpowiedź ("answered_by": "fallback") zastępuje odpowiedź basal. W przykładzie z basal-omni-1.0-ultra i Gemma 4 31B-it z myśleniem przy T = 0,8 wynik wzrósł o 1,40 pkt (95% przedział: od +0,90 do +1,89), a do modelu czatu trafiło 8,4% pytań. Ten wynik zakłada, że limit czasu nie przerwał żadnego wywołania. Jedno wywołanie trwało 54 s w medianie i 308 s w p95. Przy domyślnym --fallback-timeout 60 w 46 na 100 wywołań została odpowiedź basal, co dało około trzech czwartych zysku na tej próbie.
| Tryb | Kiedy pomaga | Pomiar | Na co uważać |
|---|---|---|---|
| Repliki na wielu GPU | ruch większy niż jedno GPU | 1,58× żądań na 2 × H100 | skalowanie nie jest liniowe |
| Kaskada mini → ultra | duży model tylko dla trudnych pytań | ~1,5× żądań, ta sama trafność | wyższe p95 przy 16 klientach |
| Blend | liczy się jakość | +0,45 pkt względem ultra | każde pytanie do każdego modelu; bez kalibracji |
| Rezerwa LLM | najtrudniejsze, rzadkie pytania | +1,40 pkt; 8,4% pytań wysłanych | mediana wywołania 54 s; bez kalibracji |
Pomiary kaskady, blendu i rezerwy pochodzą z odłożonej połowy zbioru. Szczegóły: RESULTS.md i SERVING.md.
Odpowiedzi, na których można polegać
basal zwraca skalibrowane prawdopodobieństwa. Wersja 2.5 pozwala aplikacji korzystać z nich bezpośrednio, bez własnej logiki progów:
- Zbiory odpowiedzi.
"coverage": 0.9zwraca zbiór opcji, który z tym prawdopodobieństwem zawiera właściwą. Gdy model waha się między dwiema kategoriami, zbiór zawiera obie, a człowiek wybiera już tylko spośród nich. - Wstrzymanie się od odpowiedzi. Gdy podasz
"max_error", odpowiedź wyboru, tak/nie lub skali dostaje"abstain": truewtedy, gdy pewność jest poniżej certyfikowanego progu dla jej typu. Sama odpowiedź się nie zmienia, ale aplikacja wie, że tę sprawę lepiej przekazać człowiekowi. - Drugi odczyt (
--reread T). Odpowiedzi poniżej progu T są czytane ponownie, ze stanem podanym dwa razy, a oba odczyty są łączone.--reread-imageczyta obraz ponownie przy większej liczbie tokenów. - Kolejność opcji.
basal-bench --order-checkmierzy, jak często najwyżej oceniona odpowiedź zmienia się po odwróceniu lub przesunięciu opcji.--order-average Kzwraca średnią z K kolejności i czyta stan tylko raz. Pomaga wyłącznie basal-omni-1.0-mini: +0,6 pkt top-1 na naszym zbiorze developerskim przy K = 2, kosztem mniej więcej dwukrotnie dłuższego czasu na pytanie. Na max i pico nie pomaga, dlatego jest domyślnie wyłączone.
Gotowe zestawy pytań guard_input, guard_output i route_intent mają na razie progi dobrane ręcznie, a nie certyfikowane. Przy max_error korzystają z kalibracji serwowanego modelu dla każdego typu pytania.
Więcej sprzętu i szybszy start
basal-omni-1.0-ultra, największy model rodziny, dostaje trzy tryby kwantyzacji przy ładowaniu i mieści się na mniejszych kartach. Działają one tylko dla ultra. Pozostałe modele basal-omni nie przeszły kontroli dokładności, więc silnik je w tych trybach odrzuca.
| Tryb | Sprzęt | Wynik | Uwagi |
|---|---|---|---|
--mode fp8 | jeden GPU 80 GB | 1,35× decyzji/s względem bf16; 53 zamiast 74 GB przy 16 klientach | cache stanu wyłączony do 2.5.1 |
--mode nvfp4 | Blackwell | 2,3× szybsze ocenianie niż bf16 | 2,4% odpowiedzi top-1: inne niż w bf16 |
--mode int8 | Ampere i nowsze, bez FP8 | 99,4% odpowiedzi top-1 jak w bf16 | własna kalibracja |
--quant-load cpu | karta 48 GB | ultra w fp8 lub int8 mieści się na 48 GB | kwantyzacja po jednej warstwie |
Checkpointy w repozytoriach -FP8 ładują się teraz bez kopii bf16 na GPU. Dzięki temu basal-omni-1.0-ultra-FP8 działa na jednym H100 80 GB; wcześniej przy ładowaniu brakowało pamięci. --state-cache-bits 8 przechowuje stany w cache jako 8-bitowe liczby całkowite: mieści się ich około 1,7× więcej na GB, a na basal-omni-1.0-max 99,45% najwyżej ocenionych odpowiedzi jest takich samych jak z cache 16-bitowym.
Szybszy start. basal-prepare raz zapisuje jądra dostrojone do danego GPU i wersji silnika, a --prepared auto wczytuje je przy starcie. Odpowiedzi są identyczne bajt w bajt z zimnym startem. basal-omni-pico startuje w 72 s zamiast 287 s. Repozytoria modeli mają już katalog prepared/ dla H100, a --prepared auto pobiera tylko część dla Twojego GPU i wersji. Pierwszy start na H100 z pustymi cache: basal-omni-1.0-mini 290 → 172 s, basal-omni-1.0-max 259 → 164 s. Pico na H100 daje teraz te same odpowiedzi po każdym starcie; w 2.4.1 jego odpowiedzi w trybie fast mogły się różnić między startami.
Apple Silicon. Cache stanu działa teraz w --mode mlx, z odpowiedziami identycznymi bit w bit jak bez cache. Na MacBooku Air M4 polityka o długości 2,1 tys. tokenów, zapisana w cache, skróciła czas żądania z 13,7 do 0,9 s. Opcjonalne --mlx-forward basal liczy ostatnie warstwy tylko w wierszach odpowiedzi: basal-omni-1.0-mini-MLX odpowiada na jeden prompt w 131 ms zamiast 225 ms (M4 Pro). basal-omni-pico działa na Macu w --mode mlx. Na 1 700 odłożonych promptach jego odpowiedzi zgadzają się z CUDA eager float32 (top-1 100%).
Starsze GPU. Przewodnik OLD_GPUS.md uruchamia basal-omni-pico na kartach GTX 10xx, RX 480 / 580 i Intel Iris Xe przez backend Vulkan w llama.cpp. basal-selfcheck porównuje Twoją konfigurację z odpowiedziami referencyjnymi dołączonymi do wydania.
Na produkcji: podgląd na żywo, metryki, klucze API
Strona na żywo dla basal-serve (--ui on, domyślnie wyłączona) pokazuje stan serwera, ruch od startu, cache stanu, telemetrię GPU i hosta, konfigurację oraz metadane ostatnich 200 żądań, nigdy ich treść. --ui full pokazuje także każde z tych żądań i odpowiedź. Przy jednej otwartej stronie koszt jest mały. Na H100 z basal-omni-1.0-mini przepustowość mieściła się w 1% wyniku z --ui off. Mediana opóźnienia przy 8 klientach rosła o 0,4–2,2% z 1–2 stronami i o 5,2% z --ui full. Przy jednym kliencie odpowiedzi są identyczne bajt w bajt.
Jedna strona dla routera i wszystkich replik (basal-router --ui on) pokazuje routing, gotowość, żądania w toku, błędy i ostatnie 200 żądań routera. Obok są karty replik z ich stanem, ruchem, cache stanu i telemetrią GPU. Na 2 × H100 mediana przy 8 klientach wzrosła o 1,3%, w granicach rozrzutu samego --ui off.
GET /metricsw formacie Prometheus dla basal-serve i basal-router, z wersją silnika, usunięciami z cache stanu i trafieniami prefiksu (#48). Podczas ładowania modelu serwer odpowiada HTTP 503, a nieudany start kończy proces, zamiast go zawieszać.- Klucze API (
--api-keys PATH, opcjonalnie). Plik JSON przechowuje skróty SHA-256 kluczy. Każda ścieżka pozaGET /healthwymaga klucza, a administrator widzi użycie kluczy wGET /v1/keys.--cors-originsotwiera dostęp z przeglądarki dla wskazanych domen (#68). basal-router przekazuje klucz klienta replikom, ale nigdy do--fallback. - Repliki tylko lokalnie. Repliki uruchamiane przez router z
--gpusnasłuchują na 127.0.0.1. Wcześniej nasłuchiwały na 0.0.0.0, więc były osiągalne z sieci z pominięciem routera.
Integracje: od API OpenAI po LM Studio
- OpenAI Decisions API. basal-serve odpowiada na
/v1/decisions, więcclient.decisions.createz SDK OpenAI działa z lokalnym modelem. Prawdopodobieństwa są te same co w/v1/systemone. - LM Studio (opcjonalnie).
basal-export-gguf --systemonezamienia plik basal w formacie GGUF w model decyzyjny LM Studio: wybór, skala i tak/nie, do 26 opcji, ze skalibrowanymi temperaturami i bez basal-serve. Potrzebne jest LM Studio 0.4.26 lub nowsze (kanał beta) z silnikiem llama.cpp 2.65.1 lub nowszym. Na wszystkich 607 pytaniach, na które LM Studio odpowiedziało, najwyżej oceniona odpowiedź była taka sama jak w basal-serve. LM Studio przerywa żądanie po 30 s. - Klient TypeScript (
clients/typescript, bez zależności w czasie działania): typowane pytania i odpowiedzi, zbiory odpowiedzi, abstain,ask_if/depends_on, obrazy i błędy. Na razie budujesz go z repozytorium; nie ma go jeszcze w npm. - Frameworki agentowe. Lekkie narzędzia dla LangChain, LlamaIndex i CrewAI korzystają z API HTTP (
basal.adapters). Gotowe zestawy pytań (triage, moderacja, compliance) są wbasal-run --preset. - MCP. Serwer z kilkoma modelami udostępnia
list_modelsoraz argumentmodeldla narzędzidecideidecide_many(#66). - Klient Python ma metodę dla każdego typu pytania,
AsyncBasaldla asyncio i błędy według kodu statusu (#58). - Własne modele.
basal-attachserwuje jako model decyzyjny model czatu, który nigdy nie był trenowany na basal, na przykład Gemma 4 lub Qwen. Startuje bez kalibracji; basal-calibrate dopasowuje go do Twoich oznaczonych żądań.basal-finetunetrenuje LoRA na Twoich oznaczonych decyzjach. Sprawdziliśmy go na Apple Silicon z basal-omni-pico, na innych GPU jeszcze nie. - Adaptery LoRA przy ładowaniu (
--adapter DIRw basal-serve, basal-calibrate i basal-bench). Odpowiedzi są bit w bit takie same jak z checkpointu po scaleniu, który zapisujebasal-fuse-adapter(#52).
Eksperymentalnie: rank i basal-navigate
rank ocenia tysiące kandydatów w jednym żądaniu. Najpierw przesiewa je pytaniami tak/nie, potem wybiera jednego spośród 20 najlepszych. Jedno żądanie mieści do 10 000 kandydatów. basal-navigate wyszukuje, przechodząc drzewo dokumentów poziom po poziomie: tematy, strony, fragmenty. Nie potrzebuje indeksu.
Z basal-omni-1.0-max na jednym H100, w porównaniu z gęstym modelem embeddingów 8B: MultiDoc2Dial R@1 44,3 wobec 34,7 (+9,6), ConditionalQA Hit@1 63,5 wobec 44,3 (+19,2).
Ta trafność ma swoją cenę: czas. Przy jednym zapytaniu naraz wyszukiwanie trwa p50 3,0 s i p95 3,5 s na turę MultiDoc2Dial oraz p50 9,2 s i p95 18,4 s na pytanie ConditionalQA. Przy 8 równoległych klientach mediana wynosi 24 s i 64 s. Dlatego oba narzędzia są eksperymentalne. --split-at N pozwala przeszukać drzewa większe niż limit 10 000 kandydatów, ale nie przyspiesza: na Natural Questions (2,68 mln akapitów) to 51,6 s na pytanie. Szczegóły: NAVIGATE.md.
Uczciwie o ograniczeniach
- Kaskada a najwolniejsze odpowiedzi. Kaskada mini → ultra obsługuje więcej żądań, ale przy 16 klientach jej p95 jest wyższe niż samego ultra.
- basal-navigate jest wolny: sekundy na zapytanie przy jednym kliencie i dziesiątki sekund przy ośmiu.
- Strix Halo i Apple M5 nie są sprawdzone na naszym sprzęcie.
--mode strixutrzymuje społeczność. Na karcie Radeon 8060S jedno krótkie pytanie skraca się teraz z 390 do 161 ms, ale nie sprawdziliśmy tego na własnym sprzęcie. Ustawienia float32 dla pico na Apple M5 nie sprawdziliśmy jeszcze na tym układzie; na M4 Pro odpowiedzi są identyczne jak wcześniej. - Ultra w blokowym FP8 działa bez cache stanu do 2.5.1.
--state-cache-gbjest wtedy pomijane z ostrzeżeniem przy starcie, a żądania są obsługiwane jak bez cache. - Blend i rezerwa LLM nie są skalibrowane. Przed automatyzacją dopasuj progi przez basal-calibrate. Odpowiedzi rezerwy są powtarzalne tylko z ustawieniami endpointu opisanymi w SERVING.md.
- Rzadki HTTP 500 z cache stanu. Przy
--mode fasti--state-cache-gbrzadki wyścig może zakończyć jedno żądanie błędem 500: w naszych testach około 1 na 8 000. Serwer działa dalej, a żądanie można powtórzyć. Problem istnieje od 2.3.1.--state-cache-lock ongo usuwa, ale kosztuje: na H100 z basal-omni-1.0-max, przy 8 klientach i 8 740 żądaniach, 0 błędów zamiast 1, lecz 8,19 zamiast 8,88 żądań/s (-8%) i mediana 630 zamiast 577 ms. - Długie stany w ultra. To samo żądanie o długości 24–32 tys. tokenów, wysłane ponownie, dało bitowo identyczne prawdopodobieństwa w 95 na 100 przypadków, tak jak w 2.4.1. Mini: w 100 na 100.
Dziękujemy społeczności
Duża część tego wydania przyszła w pull requestach. Dziękujemy:
- Miłosz Kucharski (@Butterski): mniej pracy CPU w kaskadzie CUDA (#44), cache torch.compile, który przetrwa restart (#47; pierwszy start basal-2.0-mini po restarcie 417 → 238 s na RTX 4060 Ti) i
--compile-scope layer(#49). - Paweł Kiszczak (@pawelkiszczak): polecenia deweloperskie i kontrole przed commitem (#46), adaptery LoRA (#52), kody błędów (#62), progi i kontekst w
/v1/models(#64), wybór modelu w MCP (#66), klucze API (#68), kalibracja na snapshotach Hugging Face (#71) oraz basal-viz z facts i dla Gemma 4 (#73, #75). - Marcin Brzeżański (@marcinbrzezanski): nowe metryki (#48) i cache stanu, który zachowuje rozgałęzienia historii (#56). W historiach agentów ponownie wykorzystuje 1,6–1,7× więcej tokenów prefiksu.
- Dariusz Koryto (@dkoryto): CI na Linuksie i macOS (#53), klient Python (#58), poprawka nazw z
::(#59) i basal-interpolate (#60). - Grzegorz Stark (@gstark0): cache stanu na Apple Silicon (#50).
- Michał Kardyś (@kardysm):
--mode strixbez czekania na kompilację jąder przy pierwszych żądaniach (#51). - Grzegorz Brzezinka (@agentGreg): testy na Apple M5 (#76) i basal-viz na silniku MLX (#78).
Miłoszowi dziękujemy też za wcześniejszy #17: dzięki niemu język stanu jest wykrywany raz na żądanie, a nie przy każdym pytaniu.
Co przyniesie 2.5.1
- Certyfikowane progi dla gotowych zestawów pytań; dziś są dobrane ręcznie.
- int8 na Apple M5.
- Cache stanu w blokowym FP8 (
--mode fp8). - Poprawkę rzadkiego HTTP 500 z
--mode fasti cache stanu, bez spadku przepustowości, który daje--state-cache-lock.
Jak zacząć
GPU NVIDIA, z uv w nowym środowisku:
uv venv --python 3.12 --allow-existing ~/basal-env && source ~/basal-env/bin/activate
uv pip install torch==2.11.0 --index-url https://download.pytorch.org/whl/cu128
uv pip install "basal[fp8] @ https://github.com/rkinas/basal/archive/refs/tags/v2.5.0.tar.gz"
basal-serve --model Remek/basal-2.0-4.5B --mode fast --template-prefix off --port 8000
Apple Silicon:
uv venv --python 3.12 --allow-existing ~/basal-mlx && source ~/basal-mlx/bin/activate
uv pip install "basal[mlx] @ https://github.com/rkinas/basal/archive/refs/tags/v2.5.0.tar.gz"
basal-serve --model Remek/basal-2.0-4.5B-MLX-8bit --mode mlx --port 8000
Dwa GPU pod jednym portem, ze stroną na żywo routera i replik:
basal-router --gpus 0,1 --port 8000 --ui on -- --model Remek/basal-omni-1.0-mini --mode fast --ui onAby dostać zbiór odpowiedzi i sygnał wstrzymania, dodaj do pytania pola coverage i max_error:
{
  "state": "Zgłoszenie klienta: zamówiona szafa dotarła z pękniętymi drzwiami. Proszę o wymianę drzwi do piątku.",
  "questions": {
    "zespol": {
      "type": "choice",
      "instructions": "Który zespół powinien obsłużyć sprawę?",
      "criteria": {
        "serwis": "Naprawy i wymiana elementów",
        "sprzedaz": "Nowe zamówienia",
        "ksiegowosc": "Rozliczenia"
      },
      "coverage": 0.9,
      "max_error": 0.01
    }
  }
}
To przykładowe żądanie; jego wyników nie symulujemy. Poziomy pokrycia pochodzą z kalibracji dopasowanej przez basal-calibrate --conformal. Gdy plik kalibracji nie ma danego poziomu, zbiór obejmuje wszystkie opcje, a pole coverage_note wyjaśnia dlaczego.
Po aktualizacji domyślne odpowiedzi się nie zmienią. Każdą nową opcję warto jednak najpierw zmierzyć na własnych żądaniach, zanim trafi na produkcję.
Pełny opis wydania i pomiary → · Serwer inferencji, REST i MCP →