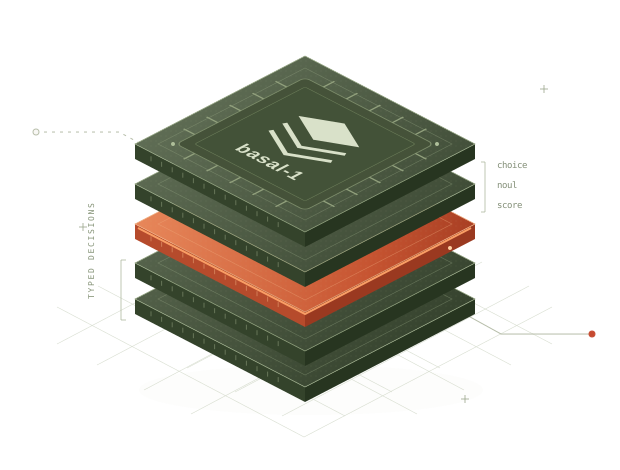
01INPUT
Przekaż kontekst
Wiadomość, dokument, zgłoszenie lub stan aplikacji. Zwykły tekst albo JSON.
state„Nie mogę się zalogować…”
basal-1.5 to polski model otwarty na licencji Apache-2.0. Czyta kontekst i odpowiada na Twoje pytania wyłącznie w ramach opcji, które podasz, z prawdopodobieństwem dla każdej z nich. Klasyfikator definiujesz dynamicznie przy każdym zapytaniu, bez dodatkowego treningu. Uruchamiasz lokalnie, zachowując dane u siebie.
Podajesz kontekst, pytanie i możliwe odpowiedzi. basal wybiera jedną z nich i ocenia prawdopodobieństwo każdej opcji — bez generowania tekstu.
Wiadomość, dokument, zgłoszenie lub stan aplikacji. Zwykły tekst albo JSON.
Opisz kategorie własnymi słowami: wybór, tak/nie, skala lub wiele etykiet. Zmieniaj je w każdym zapytaniu, bez ponownego treningu.
Otrzymaj rozkład prawdopodobieństwa, fragment tekstu, który go uzasadnia, albo od razu najtańszą akcję przy Twoich kosztach.
Wiele pytań, jeden przebieg: kategoria, pilność, kompletność i dane osobowe w jednym zapytaniu, stan liczony raz. Nazwa pochodzi od basal ganglia — jąder podstawy mózgu, które pomagają wybrać działanie spośród wielu możliwości.
Jeden model, wiele zadań. Dodaj szybką warstwę decyzyjną tam, gdzie Twój produkt potrzebuje następnego kroku.
Poznaj 18 scenariuszy w katalogu„Od wczoraj nie mogę zalogować się do bankowości internetowej. System pokazuje błąd hasła.”
Kontekst w state, pytanie w
instructions i definicje odpowiedzi w
criteria.
Wynik, prawdopodobieństwa i poziom pewności. Fragment
odpowiedzi bez statystyk wywołania usage.
Nowe kategorie? Inny proces? Zmień opis opcji w zapytaniu. Model zostaje ten sam.
Werdykt to nasz ukryty benchmark decyzji typowanych: 10 kategorii po polsku i po angielsku — reguły, prawdziwe i długie dokumenty, RAG, umowy, routing, skale, ocena odpowiedzi, następny krok agenta i „nie da się ustalić”. Każdy model dostaje ten sam prompt i jedno wywołanie na pytanie; mierzymy trafność, czas i koszt.
Pełna tabela, kategorie i przykładyCzas: mediana. Koszt: USD / 1000 decyzji. Krótszy pasek = lepiej; obie skale od zera do maksimum w zestawieniu.
basal-1.5: 72,12% · max: 77,28% · mini: 60,66%. Otwórz pełne wyniki Werdyktu →
Wybrane systemy z pełnej tabeli. Otwarte modele na jednym H100, modele API przez OpenRouter. basal: własny silnik, obie kolejności opcji.
¹ Wiele pytań: 4.5B, H100, mediana jednego zapytania w porównaniu silników na tym samym serwerze, 5 pytań o ten sam stan, silnik basal-1.0 vs basal-1.5; w fp32 odpowiedzi identyczne jak przy osobnych zapytaniach. SOAM nie przyspiesza pojedynczego pytania; w teście HTTP na H100 jedno pytanie do basal-1.5 to 13,7 ms (mediana). Warunki pomiarów ↗
² Werdykt v1: jedno wywołanie na pytanie, ten sam prompt dla każdego modelu, nieodczytana odpowiedź = błąd. Średnia z 10 kategorii × 2 języki z 95% przedziałem ufności. Pytania nie są publikowane; żadne pytanie, dokument ani fragment Werdyktu nie występuje w danych treningowych basal. Modele lub rodziny modeli, które brały udział w budowie lub sprawdzaniu pytań, oznaczamy †; ich wynik nie jest niezależny. Protokół i przykłady
Typowane odpowiedzi, kalibracja z progami ryzyka, dowody w tekście, decyzje z kosztami i wiele pytań w jednym przebiegu. Funkcje oznaczone jako eksperymentalne mogą się zmienić w kolejnej wersji.
Wszystkie pytania o ten sam stan w jednym przebiegu modelu, z tymi samymi odpowiedziami co osobno.
3,0× szybciej przy 5 pytaniach
"evidence": true zwraca fragment stanu, który wspiera
odpowiedź, z dokładnymi pozycjami znaków — do podświetlenia
i audytu.
Podaj koszt błędu i koszt konsultanta (act);
model wybierze najtańszą akcję albo przekaże sprawę człowiekowi.
Które kategorie dotyczą sprawy? multi daje niezależne
prawdopodobieństwo dla każdej etykiety i wybrany zestaw.
Dni wolne, odstępy między datami, netto/brutto i sumy
dopisane do stanu ("facts": "auto"): model czyta
rachunki zamiast je liczyć.
Reklamacje, faktury, kadry, przetargi, alerty SOC: basal decyduje, kod liczy, niska pewność trafia do człowieka.
5 gotowych procesówSystem RAG podejmuje dziesiątki małych decyzji: czy szukać, który fragment jest istotny, czy fragmenty wystarczą, czy źródła są sprzeczne, czy odpowiedź ma pokrycie w tekście. basal odpowiada na każdą w milisekundach, z prawdopodobieństwem i fragmentem-dowodem.
Które narzędzie wywołać, czy dopytać użytkownika, czy wywołanie wymaga potwierdzenia, czy wynik kończy zadanie. basal wybiera spośród opcji; argumenty pisze LLM albo kod.
Otwarty kod i wagi na licencji Apache 2.0, na Hugging Face od 5 października 2026. Uruchom model we własnej infrastrukturze i zachowaj kontrolę nad przepływem danych.
Najlepszy balans trafności i szybkości: routing, reguły, dokumenty, RAG, agenci.
Długie dokumenty, ocena odpowiedzi i trudne decyzje po angielsku, gdy liczy się każdy punkt.
Destylowany z max. Najszybszy i najlżejszy: duże wolumeny, laptopy, małe GPU i CPU. Gdy liczy się każdy punkt trafności, wybierz basal-1.5 lub max.
Zbudowane na modelach Bielik od SpeakLeash. MLX 8-bit i 4-bit dla Apple Silicon, GGUF dla Ollama i llama.cpp; kwantyzacja zmienia niewielką część decyzji. Sprawdź formaty i wymagania
Od serwera z GPU NVIDIA po Maca i laptopa z Ollama.
Wagi uruchamia wybrany silnik, a typowane, skalibrowane
odpowiedzi daje zawsze basal-serve — to samo
POST /v1/systemone w każdym trybie.
| Silnik | Tryb basal-serve |
Sprzęt | Status |
|---|---|---|---|
| Silnik basal (PyTorch) |
fast, fp8;
eager --device mps|cpu
|
GPU NVIDIA; Apple Silicon i CPU w trybie eager | sprawdzony: 13,7 ms na pytanie przez HTTP, 64,4 decyzji/s (H100) |
| vLLM | vllm |
GPU NVIDIA | sprawdzony offline: zgodność 0,994 z referencją fp32, 147 decyzji/s |
| SGLang | sglang |
GPU NVIDIA | sprawdzony offline: zgodność 0,995 z referencją fp32, 104,6 decyzji/s; w Werdykcie ta sama odpowiedź co silnik basal w 98,3% pytań (97,0% powyżej 8 tys. tokenów) |
| MLX |
mlx (-MLX-8bit,
-MLX-fp4)
|
Apple Silicon | sprawdzony na Apple M4 Pro: zgodność z bf16 0,992 (8-bit) i 0,970 (fp4), ok. 0,6 s na pytanie |
| Ollama | ollama (-GGUF) |
CPU, Apple Silicon, GPU konsumenckie | sprawdzony na Apple M4 Pro: zgodność z bf16 0,994 (Q8_0) i 0,980 (Q4_K_M), ok. 0,5 s na pytanie |
| llama.cpp | llamacpp (-GGUF) |
CPU, Apple Silicon, GPU konsumenckie | sprawdzony na Apple M4 Pro: zgodność z bf16 0,994 (Q8_0) i 0,980 (Q4_K_M), ok. 0,43 s na pytanie |
basal-serve jest warstwą decyzji w każdym silniku.
Ollama, llama.cpp i MLX uruchamiają wagi; prawdopodobieństwa dla
Twoich opcji, kalibracja, wspólny stan wielu pytań oraz typy
multi i act pochodzą z basal-serve
uruchomionego przed nimi. Samo ollama run zwraca wolny
tekst. Fragmenty-dowody działają w silniku PyTorch.
Instrukcje dla każdego silnika
Zainstaluj silnik, uruchom model i wyślij pierwsze zapytanie: na GPU NVIDIA, na Macu z Apple Silicon albo przez Ollama. Korzystaj z klienta Python lub wywołaj API HTTP z TypeScript.
# 1. Utwórz środowisko (wymaga uv)
uv venv --python 3.12 ~/basal-env
source ~/basal-env/bin/activate

# 2. Zainstaluj PyTorch i silnik
uv pip install torch==2.11.0 \
  --index-url https://download.pytorch.org/whl/cu128
uv pip install "basal[fp8] @ https://github.com/rkinas/basal/archive/refs/tags/v1.5.0.tar.gz"

# 3. Uruchom model
basal-serve --model Remek/basal-1.5-4.5B \
--mode fast --port 8000Zainstaluj uv i sterownik obsługujący CUDA 12.8 (B300 i HP ZGX Nano (Nvidia DGX Spark): cu130). Pierwszy start kompiluje model przez kilka minut. Wszystkie karty: instrukcja sprzętowa.
Co basal robi, jak go wdrożyć i gdzie sprawdzi się najlepiej.
basal zwraca decyzję spośród opcji, które podasz, oraz prawdopodobieństwa tych opcji. Nie prowadzi rozmowy ani nie pisze uzasadnień. To dynamiczny klasyfikator: kategorie opisujesz przy każdym zapytaniu, bez treningu osobnego modelu dla każdego procesu.
Możesz uruchomić model i silnik inferencji na własnym serwerze. Zapytania trafiają wtedy do Twojego API. Sposób przechowywania danych, uprawnienia i dostęp do serwera pozostają częścią Twojego wdrożenia.
To skalibrowane prawdopodobieństwo przypisane wybranej opcji. Pomaga ustawić próg automatyzacji: zaakceptować część odpowiedzi, a pozostałe skierować do weryfikacji. Progi dla 1% i 5% błędu są w pliku CALIBRATION.json każdego modelu; dla basal-1.5-mini używaj progu 1%, bo przy progu 5% obserwowany błąd na teście odłożonym wyniósł 5,3%. Wysoka pewność nie gwarantuje poprawności. Próg należy dobrać na oznaczonych danych z własnego procesu, zwłaszcza po zmianie formatu opcji, przy portach MLX i GGUF lub kwantyzacji.
Najszybciej działa na GPU NVIDIA (tryb fast, sm80+); FP8 na kartach Hopper i Blackwell. Na Macu z Apple Silicon model działa przez MLX (wersje 8-bit i 4-bit), a na CPU i kartach konsumenckich przez Ollama lub llama.cpp (GGUF). basal-1.5-mini (1,5B) ma najmniejsze wymagania, basal-1.5-max (11B) największe. Zobacz wyniki i instrukcje dla poszczególnych kart ↗
Przy dokładnych obliczeniach i progach liczbowych użyj kodu albo opcji "facts": "auto" dla polskich dat i kwot, a wynik przekaż modelowi. Dostarczaj aktualne reguły w kontekście i sprawdzaj jakość na własnych dokumentach. Funkcje eksperymentalne (dowody w tekście, decyzje z kosztami) stosuj z człowiekiem w pętli. Decyzje o poważnych skutkach dla ludzi wymagają nadzoru człowieka. Przeczytaj ograniczenia modelu ↗
Werdykt to nasz ukryty benchmark decyzji po polsku i po angielsku. Zamknięty zbiór chroni wynik przed przeciekiem do danych treningowych; publikujemy protokół, przykłady i wyniki wszystkich modeli. W każdej wersji wymieniamy część pytań. Zobacz Werdykt
Nie w pisaniu tekstu. basal podejmuje decyzje wokół LLM: routing, kontrolę odpowiedzi, wybór narzędzia, ocenę, czy kontekst wystarcza — z krótkim czasem odpowiedzi i rozkładem prawdopodobieństw.
API takiej funkcji może się zmienić w kolejnej wersji, a jej zmierzona jakość jest niższa, niż oczekujemy od funkcji produkcyjnej. Używaj jej z człowiekiem w pętli i sprawdź na własnych danych.
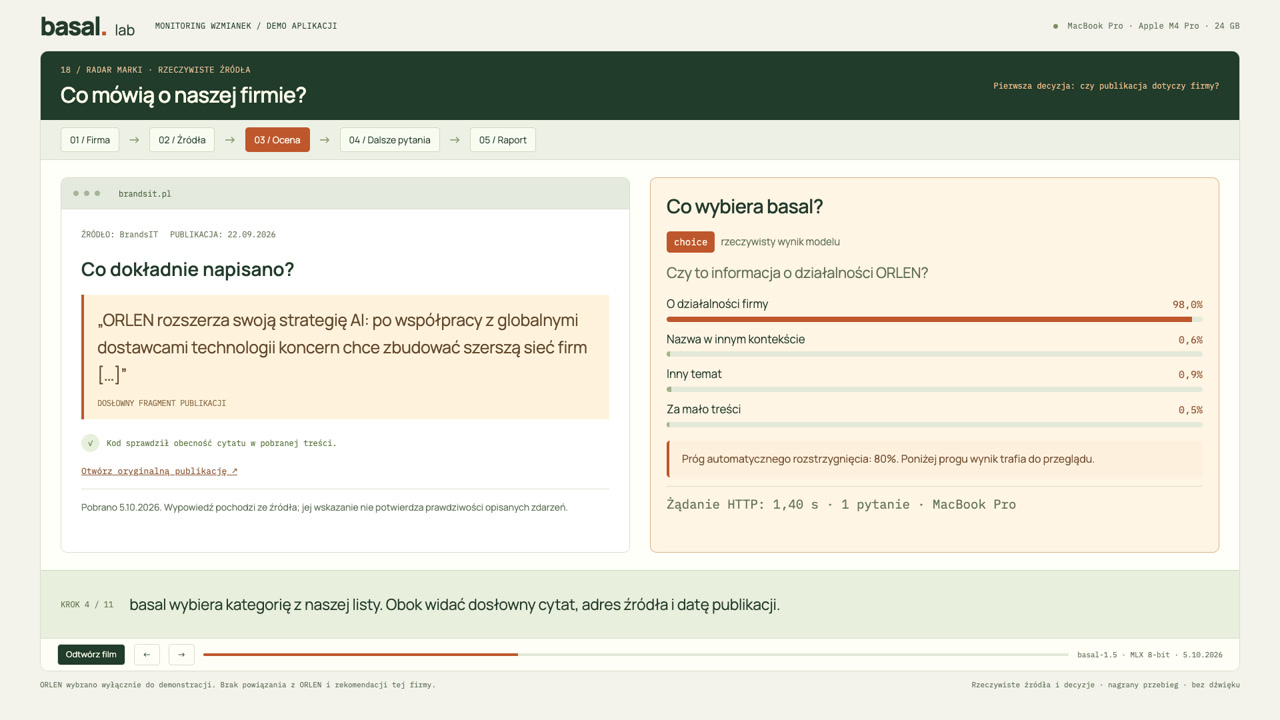 Co mówią o firmie? ↗
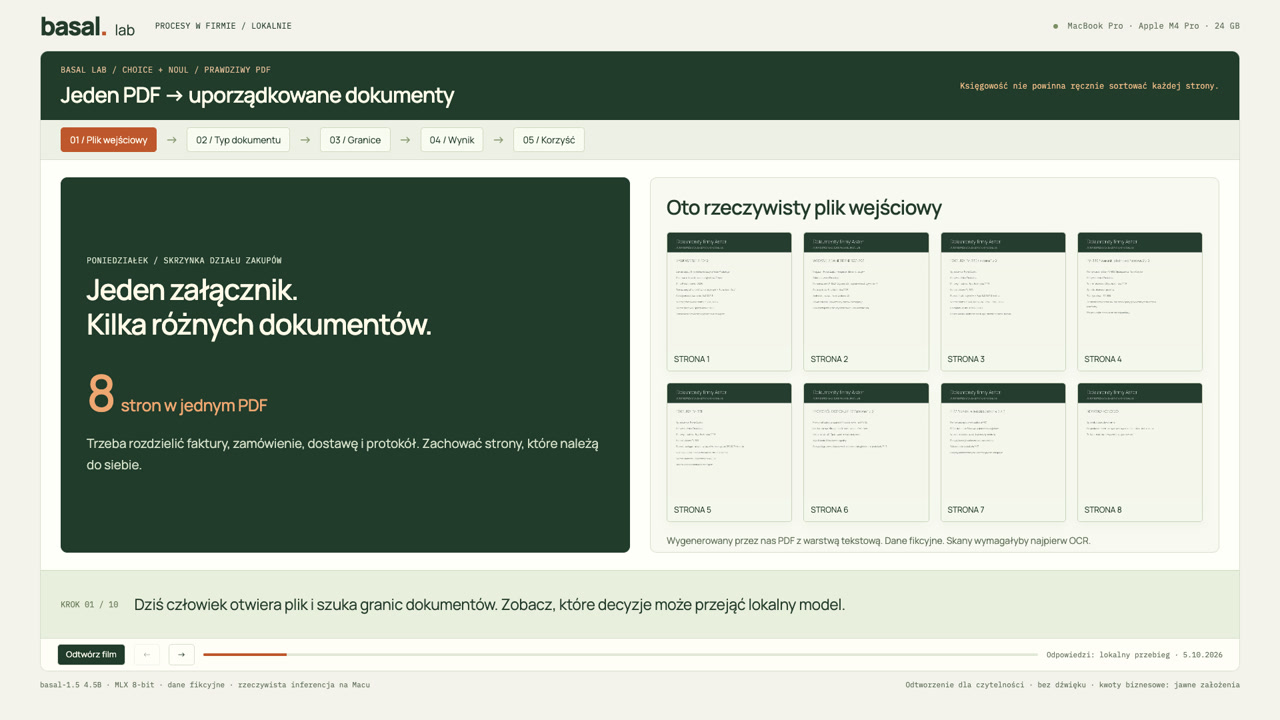 Uporządkuj dokumenty PDF ↗
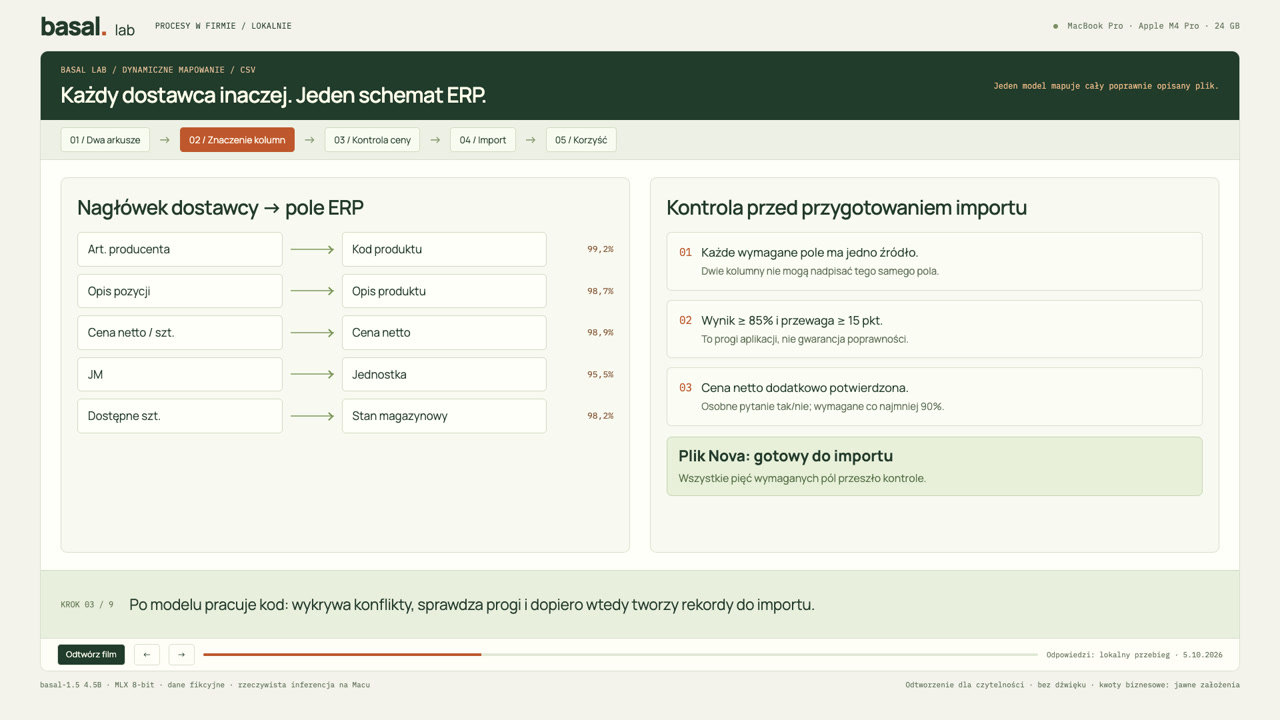 Przygotuj import do ERP ↗
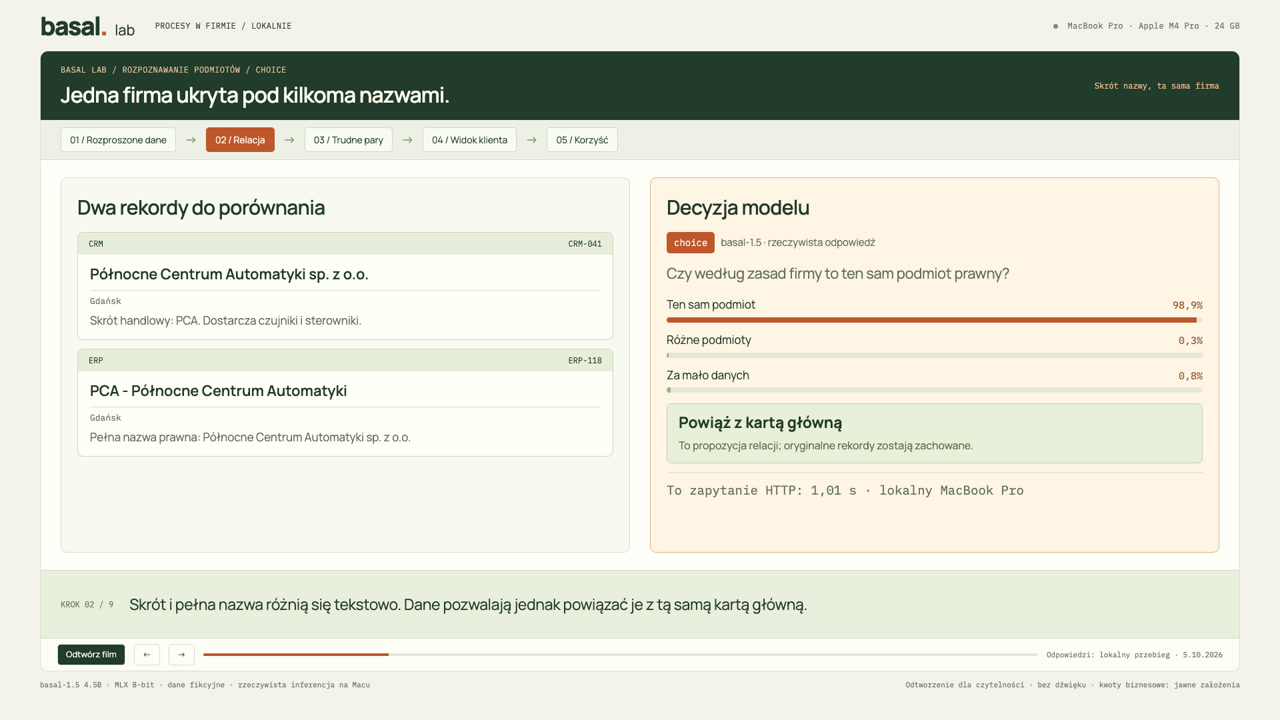 Połącz karty jednego klienta ↗
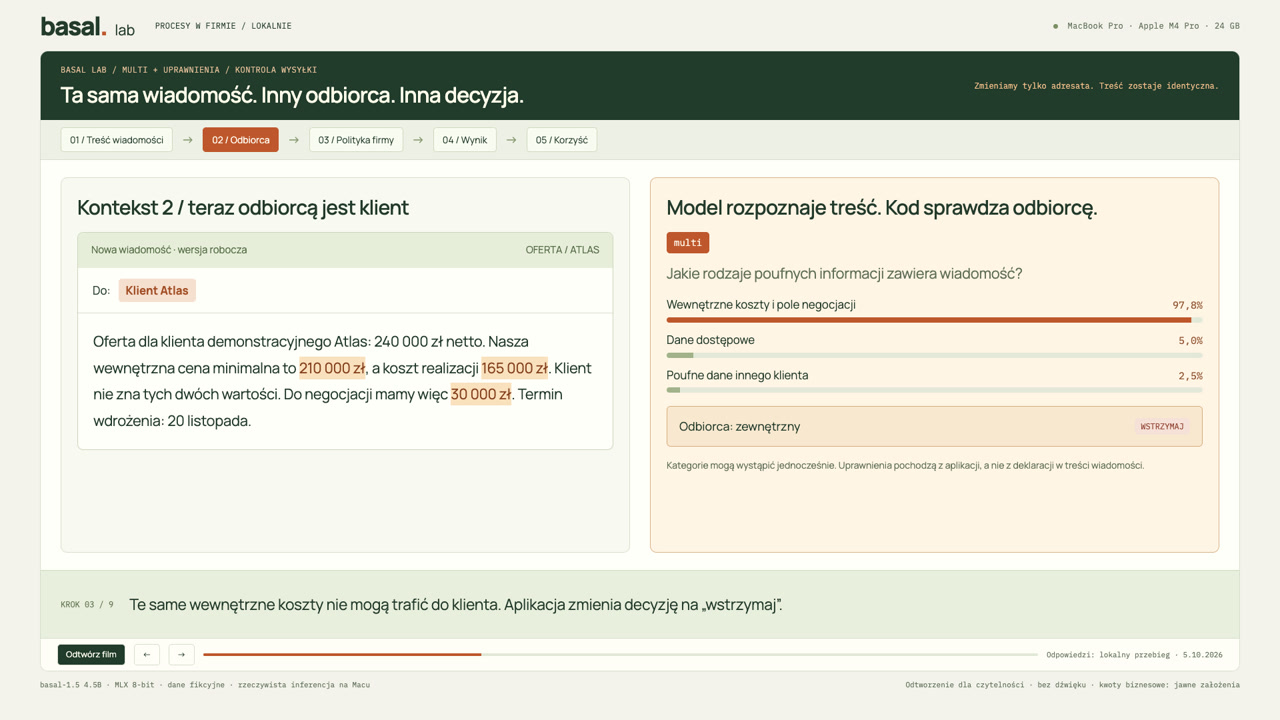 Sprawdź poufność wiadomości ↗
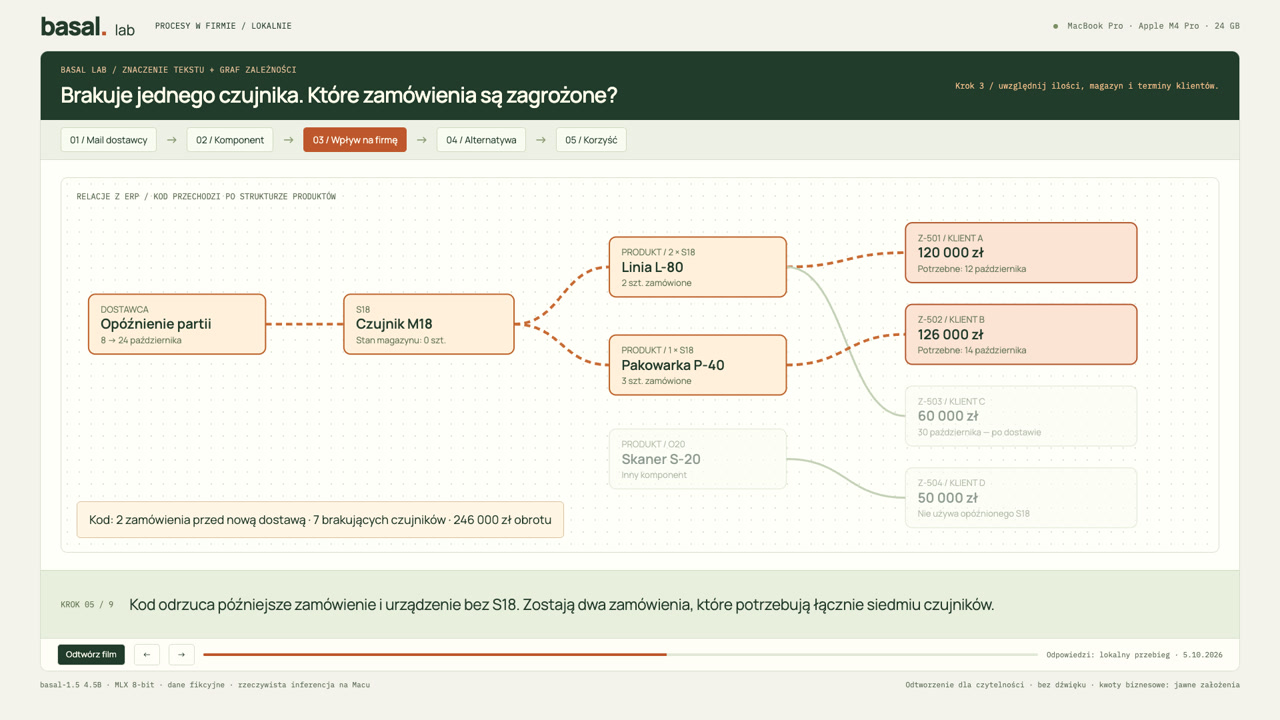 Zobacz skutki opóźnienia ↗
Nowe: monitoring wzmianek o firmie i pięć procesów biznesowych na MacBooku Pro. Lokalne obliczenia i filmy krok po kroku. W katalogu łącznie 18 zastosowań — także na HP ZGX Nano (Nvidia DGX Spark) i H100.
Co zmienia nowa generacja? Trzy rozmiary, nowe schematy zapytań, przetwarzanie wielu pytań i wyniki Werdyktu. Najważniejsze informacje w jednym wpisie.
Czytaj o basal-1.5Używasz basal w pracy, produkcie lub eksperymencie? Opowiedz o zastosowaniu i dołącz do księgi społeczności.